Hadoop3.X【HDFS】
概述
HDFS的产生背景和定义
HDFS 产生背景
随着数据量越来越大,在一个操作系统存不下所有的数据,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需要一种系统来管理多台机器上的文件,这就是分布式文件管理系统。HDFS 只是分布式文件管理系统中的一种。
HDFS 定义
HDFS(Hadoop Distributed File System),它是一个文件系统,用于存储文件,通过目录树来定位文件;其次,它是分布式的,由很多服务器联合起来实现其功能,集群中的服务器有各自的角色。
HDFS 的使用场景:适合一次写入,多次读出的场景。一个文件经过创建、写入和关闭之后就不需要改变。
HDFS优缺点
优点
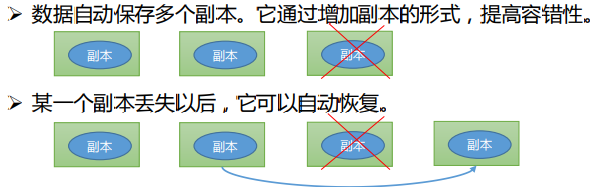
高容错性
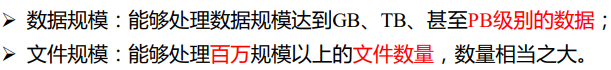
适合处理大数据
可构建在廉价机器上,通过多副本机制,提高可靠性。
缺点
不适合低延时数据访问,比如毫秒级的存储数据,是做不到的。
无法高效的对大量小文件进行存储。
(1)存储大量小文件的话,它会占用NameNode大量的内存来存储文件目录和块信息。这样是不可取的,因为NameNode的内存总是有限的;
(2)小文件存储的寻址时间会超过读取时间,它违反了HDFS的设计目标。不支持并发写入、文件随机修改。
(1)一个文件只能有一个写,不允许多个线程同时写;
(2)仅支持数据append(追加),不支持文件的随机修改。
组成
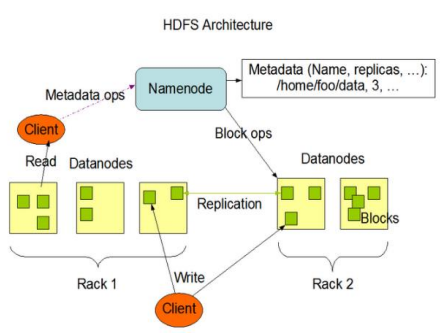
(1) NameNode(nn):就是Master,它是一个主管、管理者。
- 管理HDFS的名称空间;
- 配置副本策略;
- 管理数据块(Block)映射信息;
- 处理客户端读写请求。
(2) DataNode:就是Slave。NameNode下达命令,DataNode执行实际的操作。
- 存储实际的数据块;
- 执行数据块的读/写操作
(3) Client:就是客户端。
- 文件切分。文件上传HDFS的时候,Client将文件切分成一个一个的Block,然后进行上传;
- 与NameNode交互,获取文件的位置信息;
- 与DataNode交互,读取或者写入数据;
- Client提供一些命令来管理HDFS,比如NameNode格式化;
- Client可以通过一些命令来访问HDFS,比如对HDFS增删查改操作
(4) Secondary NameNode:并非NameNode的热备。当NameNode挂掉的时候,它并不能马上替换NameNode并提供服务。
- 辅助NameNode,分担其工作量,比如定期合并Fsimage和Edits,并推送给NameNode ;
- 在紧急情况下,可辅助恢复NameNode。
HDFS文件块大小
HDFS中的文件在物理上是分块存储(Block),块的大小可以通过配置参数( dfs.blocksize)来规定,默认大小在Hadoop2.x/3.x版本中是128M,1.x版本中是64M。
思考:为什么块的大小不能设置太小,也不能设置太大?
(1)HDFS的块设置太小,会增加寻址时间,程序一直在找块的开始位置;
(2)如果块设置的太大,从磁盘传输数据的时间会明显大于定位这个块开始位置所需的时间。导致程序在处理这块数据时,会非常慢。
总结:HDFS块的大小设置主要取决于磁盘传输速率。
HDFS的Shell相关操作 (开发重点)
基本语法
hadoop fs 具体命令 OR hdfs dfs 具体命令
两个是完全相同的。
命令大全
[root@hadoop102 hadoop-3.1.3]$ bin/hadoop fs |
常用的命令实操
准备工作
- 启动Hadoop集群
[hdfs@hadoop102 hadoop-3.1.3]$ sbin/start-dfs.sh
[hdfs@hadoop103 hadoop-3.1.3]$ sbin/start-yarn.sh - -help:输出这个命令参数
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -help rm
- 创建/sanguo 文件夹
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -mkdir /sanguo
上传
-moveFromLocal:从本地剪切粘贴到 HDFS[hdfs@hadoop102 hadoop-3.1.3]$ vim shuguo.txt
输入:
shuguo
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -moveFromLocal ./shuguo.txt /sanguo-copyFromLocal:从本地文件系统中拷贝文件到 HDFS 路径去[atguigu@hadoop102 hadoop-3.1.3]$ vim weiguo.txt
输入:
weiguo
[atguigu@hadoop102 hadoop-3.1.3]$ hadoop fs -copyFromLocal weiguo.txt /sanguo-put:等同于 copyFromLocal,生产环境更习惯用 put[hdfs@hadoop102 hadoop-3.1.3]$ vim wuguo.txt
输入:
wuguo
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -put ./wuguo.txt /sanguo-appendToFile:追加一个文件到已经存在的文件末尾[hdfs@hadoop102 hadoop-3.1.3]$ vim liubei.txt
输入:
liubei
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -appendToFile liubei.txt /sanguo/shuguo.txt
下载
-copyToLocal:从 HDFS 拷贝到本地[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -copyToLocal /sanguo/shuguo.txt ./
-get:等同于 copyToLocal,生产环境更习惯用 get[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -get /sanguo/shuguo.txt ./shuguo2.txt
HDFS 直接操作
-ls: 显示目录信息[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -ls /sanguo
-cat:显示文件内容[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -cat /sanguo/shuguo.txt
-chgrp、-chmod、-chown:Linux文件系统中的用法一样,修改文件所属权限[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -chmod 666 /sanguo/shuguo.txt
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -chown hdfs:hdfs /sanguo/shuguo.txt-mkdir:创建路径[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -mkdir /jinguo
-cp:从 HDFS 的一个路径拷贝到 HDFS 的另一个路径[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -cp /sanguo/shuguo.txt /jinguo
-mv:在 HDFS 目录中移动文件[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -mv /sanguo/wuguo.txt /jinguo
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -mv /sanguo/weiguo.txt /jinguo-tail:显示一个文件的末尾 1kb 的数据[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -tail /jinguo/shuguo.txt
-rm:删除文件或文件夹[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -rm /sanguo/shuguo.txt
-rm -r:递归删除目录及目录里面内容[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -rm -r /sanguo
-du统计文件夹的大小信息[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -du -s -h /jinguo
27 81 /jinguo
[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -du -h /jinguo
14 42 /jinguo/shuguo.txt
7 21 /jinguo/weiguo.txt
6 18 /jinguo/wuguo.tx-setrep:设置 HDFS 中文件的副本数量[hdfs@hadoop102 hadoop-3.1.3]$ hadoop fs -setrep 10 /jinguo/shuguo.txt
这里设置的副本数只是记录在 NameNode 的元数据中,是否真的会有这么多副本,还得看 DataNode 的数量。因为目前只有 3 台设备,最多也就 3个副本,只有节点数的增加到 10台时,副本数才能达到 10。
HDFS的客户端API操作
window下的环境准备
找到资料包路径下的
Windows依赖文件夹,拷贝 hadoop-3.1.0 到非中文路径(比如 d:\)【建议】。配置
HADOOP_HOME环境变量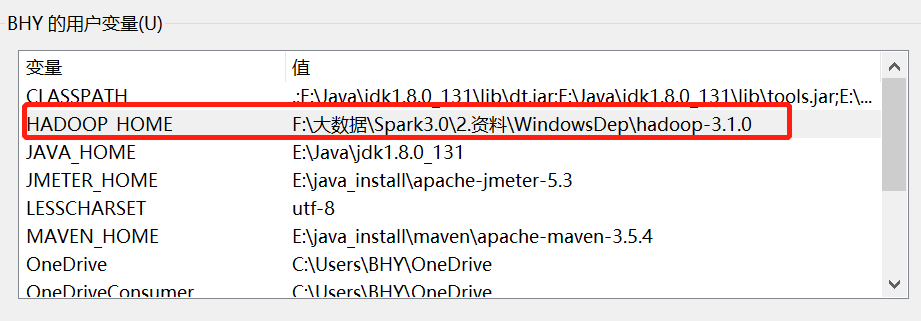
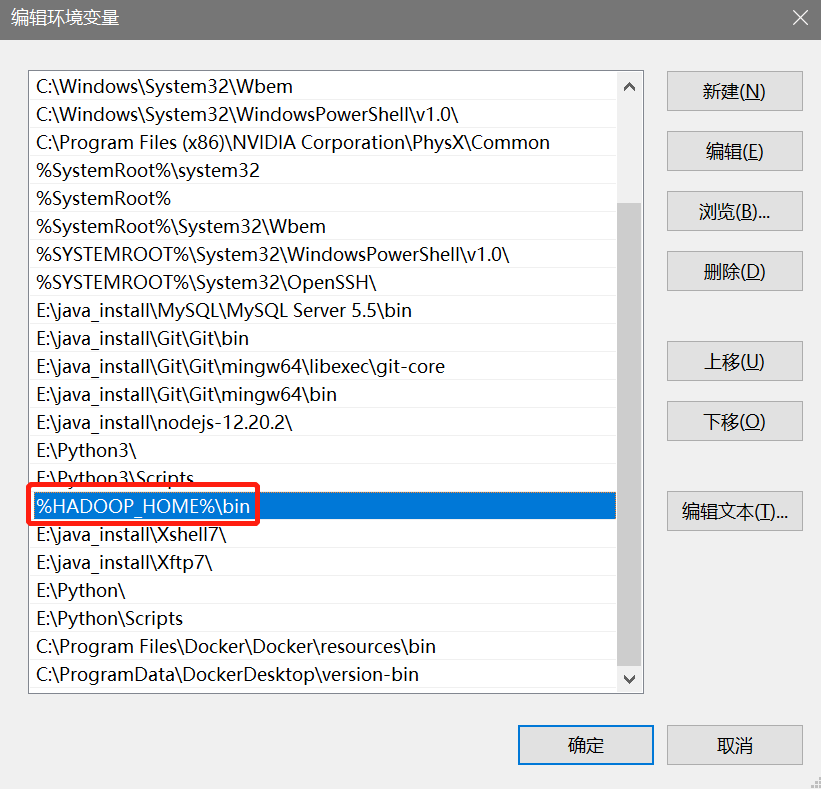
配置
Path环境变量。
注意:如果环境变量不起作用,可以重启电脑试试。%HADOOP_HOME%\bin
在 IDEA 中创建一个 Maven 工程 HdfsClientDemo,并导入相应的依赖坐标+日志添加
<dependencies>
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-client</artifactId>
            <version>3.1.3</version>
        </dependency>
        <dependency>
            <groupId>junit</groupId>
            <artifactId>junit</artifactId>
            <version>4.12</version>
        </dependency>
        <dependency>
            <groupId>org.slf4j</groupId>
            <artifactId>slf4j-log4j12</artifactId>
            <version>1.7.30</version>
        </dependency>
    </dependencies>
在项目的
src/main/resources目录下,新建一个文件,命名为"log4j.properties",在文件中填入=INFO, stdout
=org.apache.log4j.ConsoleAppender
=org.apache.log4j.PatternLayout
=%d %p [%c] - %m%n
=org.apache.log4j.FileAppender
=target/spring.log
=org.apache.log4j.PatternLayout
=%d %p [%c] - %m%n创建包名:com.atguigu.hdfs
创建 HdfsClient 类
package com.atgui.hdfs;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.junit.Test;
import java.io.IOException;
import java.net.URI;
import java.net.URISyntaxException;
public class HdfsClient {
public void testMkdirs() throws IOException, URISyntaxException, InterruptedException {
// 1 获取文件系统
Configuration configuration = new Configuration();
// FileSystem fs = FileSystem.get(newURI("hdfs://hadoop102:8020"), configuration);
FileSystem fs = FileSystem.get(new URI("hdfs://hadoop102:8020"), configuration,"zzf");
// 2 创建目录
fs.mkdirs(new Path("/xiyou/huaguoshan/"));
// 3 关闭资源
fs.close();
}
}客户端去操作 HDFS 时,是有一个用户身份的。默认情况下,HDFS 客户端 API 会从采用 Windows 默认用户访问 HDFS,会报权限异常错误。所以在访问 HDFS 时,一定要配置用户。
org.apache.hadoop.security.AccessControlException: Permission denied: user=56576, access=WRITE, inode="/xiyou/huaguoshan":atguigu:supergroup:drwxr-xr-x
HDFS的API案例实操
HDFS文件上传(测试参数优先级)
编写源代码
/**
* HDFS文件上传
* @throws IOException
* @throws InterruptedException
* @throws URISyntaxException
*/
public void testCopyFromLocalFile() throws IOException, InterruptedException, URISyntaxException {
// 1 获取文件系统
Configuration configuration = new Configuration();
configuration.set("dfs.replication", "2");
FileSystem fs = FileSystem.get(new URI("hdfs://hadoop102:8020"), configuration, "zzf");
// 2 上传文件
fs.copyFromLocalFile(new Path("C:\\Users\\BHY\\Desktop\\sunwukong.txt"), new Path("/xiyou/huaguoshan"));
// 3 关闭资源
fs.close();
}将
hdfs-site.xml拷贝到项目的resources资源目录下
<configuration>
<property>
<name>dfs.replication</name>
<value>1</value>
</property>
</configuration>参数优先级
参数优先级排序:(1)客户端代码中设置的值 >(2)ClassPath 下的用户自定义配置文件 >(3)然后是服务器的自定义配置(xxx-site.xml)>(4)服务器的默认配置(xxx-default.xml)
HDFS 文件下载
/** |
注意:如果执行上面代码,下载不了文件,有可能是你电脑的微软支持的运行库少,需要安装一下微软运行库。
HDFS 文件更名和移动
/** |
HDFS 删除文件和目录
/** |
HDFS 文件详情查看
查看文件名称、权限、长度、块信息
/** |
HDFS 文件和文件夹判断
/** |
HDFS的读写流程(面试重点)
HDFS写数据流程
剖析文件写入
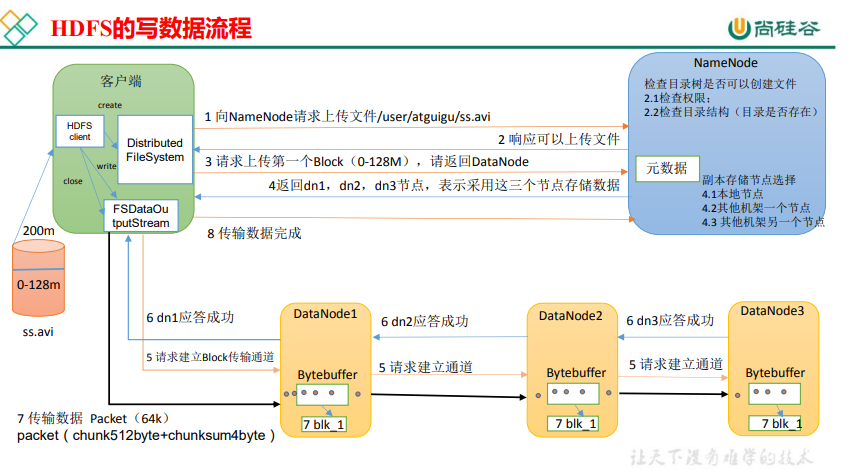
- 客户端通过
Distributed FileSystem模块向NameNode请求上传文件,NameNode检查目标文件是否已存在,父目录是否存在。 NameNode返回是否可以上传。- 客户端请求第一个
Block上传到哪几个DataNode服务器上。 NameNode返回 3 个DataNode节点,分别为dn1、dn2、dn3。- 客户端通过
FSDataOutputStream模块请求dn1上传数据,dn1收到请求会继续调用dn2,然后dn2调用dn3,将这个通信管道建立完成。 dn1、dn2、dn3逐级应答客户端。- 客户端开始往
dn1上传第一个Block(先从磁盘读取数据放到一个本地内存缓存),以Packet为单位,dn1收到一个Packet就会传给dn2,dn2传给dn3;dn1每传一个packet会放入一个应答队列等待应答。 - 当一个
Block传输完成之后,客户端再次请求NameNode上传第二个Block的服务器。(重复执行 3-7 步)。
网络拓扑-节点距离计算
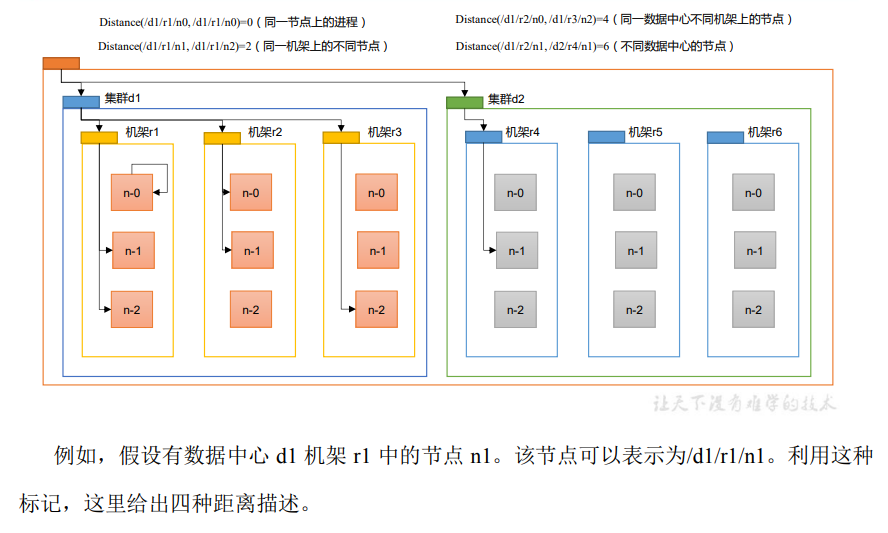
在 HDFS 写数据的过程中,NameNode 会选择距离待上传数据最近距离的 DataNode 接收数据。那么这个最近距离怎么计算呢
节点距离:两个节点到达最近的共同祖先的距离总和。
HDFS读数据流程
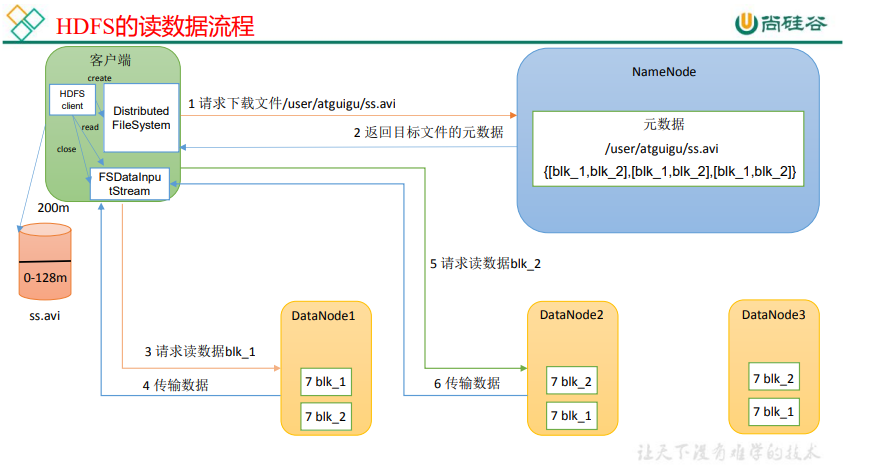
- 客户端通过
DistributedFileSystem向NameNode请求下载文件,NameNode通过查询元数据,找到文件块所在的DataNode地址。 - 挑选一台
DataNode(就近原则,然后随机)服务器,请求读取数据。 DataNode开始传输数据给客户端(从磁盘里面读取数据输入流,以Packet为单位来做校验)。- 客户端以
Packet为单位接收,先在本地缓存,然后写入目标文件。
NameNode 和 SecondaryNameNode
NN 和 2NN 工作机制
思考:
NameNode中的元数据是存储在哪里的?
首先,我们做个假设,如果存储在 NameNode 节点的磁盘中,因为经常需要进行随机访问,还有响应客户请求,必然是效率过低。因此,元数据需要存放在内存中。但如果只存在内存中,一旦断电,元数据丢失,整个集群就无法工作了。因此产生在磁盘中备份元数据的FsImage。
这样又会带来新的问题,当在内存中的元数据更新时,如果同时更新 FsImage,就会导致效率过低,但如果不更新,就会发生一致性问题,一旦 NameNode 节点断电,就会产生数据丢失。因此,引入 Edits 文件(只进行追加操作,效率很高)。每当元数据有更新或者添加元据时,修改内存中的元数据并追加到 Edits 中。这样,一旦 NameNode 节点断电,可以通过 FsImage 和 Edits 的合并,合成元数据。
但是,如果长时间添加数据到 Edits 中,会导致该文件数据过大,效率降低,而且一旦断电,恢复元数据需要的时间过长。因此,需要定期进行 FsImage 和 Edits 的合并,如果这个操作由NameNode节点完成,又会效率过低。因此,引入一个新的节点SecondaryNamenode,专门用于 FsImage 和 Edits 的合并。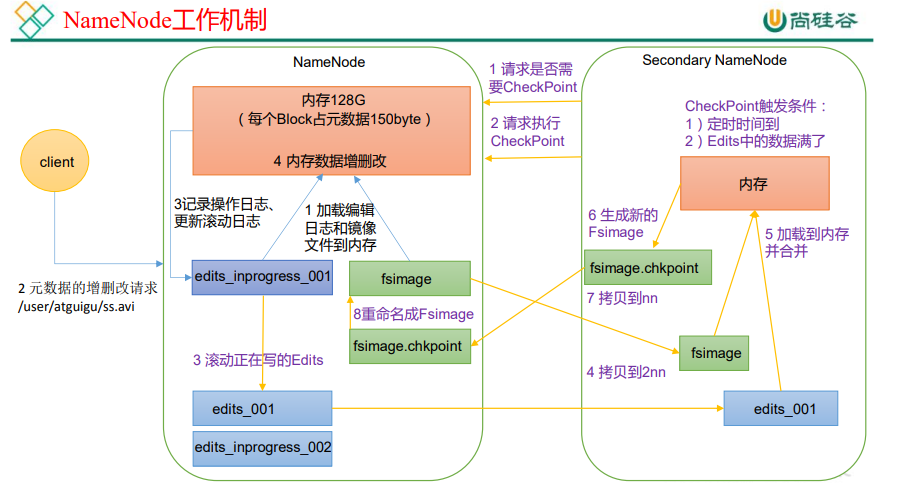
第一阶段:
NameNode启动
(1)第一次启动NameNode格式化后,创建Fsimage和Edits文件。如果不是第一次启动,直接加载编辑日志和镜像文件到内存。
(2)客户端对元数据进行增删改的请求。
(3)NameNode记录操作日志,更新滚动日志。
(4)NameNode在内存中对元数据进行增删改。第二阶段:
Secondary NameNode工作
(1)Secondary NameNode询问NameNode是否需要CheckPoint。直接带回NameNode是否检查结果。
(2)Secondary NameNode请求执行CheckPoint。
(3)NameNode滚动正在写的Edits日志。
(4)将滚动前的编辑日志和镜像文件拷贝到Secondary NameNode。
(5)Secondary NameNode加载编辑日志和镜像文件到内存,并合并。
(6)生成新的镜像文件fsimage.chkpoint。
(7)拷贝fsimage.chkpoint到NameNode。
(8)NameNode将fsimage.chkpoint重新命名成fsimage。